اگر فهرست مدلها در ChatGPT Work یا Codex برایتان شبیه چند نام نزدیک به هم است، از این قاعده شروع کنید: Luna برای کار روشن و پرتکرار، Sol برای پروژهٔ چندمرحلهای، Astra برای سختترین کارها. بعد میزان تفکر را از Medium بالا ببرید فقط وقتی کار واقعاً به برنامهریزی و بررسی بیشتر نیاز دارد. گزینهٔ Fast سرعت را بالا میبرد، اما سهمیه یا کردیت بیشتری مصرف میکند. این راهنما هفت گزینهٔ اسکرینشات، هزینه و دسترسی هر پلن را کنار هم میگذارد.
خبر زمانی مهم: طبق اعلام رسمی OpenAI، GPT-5.5 در چهارشنبه ۲۲ مهر ۱۴۰۵، برابر با ۱۴ اکتبر ۲۰۲۶ از فهرست مدلهای ChatGPT، ChatGPT Work و Codex در همهٔ پلنها کنار میرود. این بازنشستگی شامل OpenAI API نیست. اگر GPT-5.5 را در تنظیم پیشفرض، عامل سفارشی، کار زمانبندیشده یا اسکریپت گذاشتهاید، پیش از این تاریخ جایگزینش کنید.
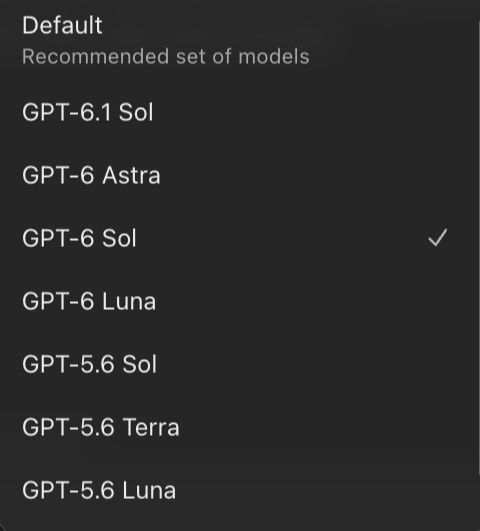
این مقاله دربارهٔ Codex و ChatGPT Work است. مدلهای GPT-6.1 Sol، GPT-6 Sol و GPT-6 Luna در محصول ChatGPT برای Work و Codex معرفی شدهاند، نه گفتوگوی معمولی Chat. نام مدل، پلن و دسترسی در API هم قواعد جداگانهای دارند. فهرست رسمی مدلها مبنای توضیحهای زیر است.
هفت مدل داخل تصویر، به زبان کاربرد
| مدل | چه وقت انتخابش کنیم؟ | چه وقت سراغ گزینهٔ دیگر برویم؟ |
|---|---|---|
| GPT-6.1 Sol | کدنویسی پیچیده، پروژهٔ طولانی، کار روی چند فایل یا سند که قرار است بازبینی شود. | برای استخراج ساده یا تغییر کوچک، Luna اقتصادیتر است. |
| GPT-6 Astra | تحلیل دشوار، کار انتهابهانتها با ابزارها، پژوهش و تحویل حساس که قضاوت و بررسی دقیق میخواهد. | برای کارهای تکراری، مصرفش ممکن است توجیه نداشته باشد. |
| GPT-6 Sol | کار فنی و چندمرحلهای روزمره؛ گزینهٔ معقول اگر 6.1 Sol هنوز در حساب شما فعال نشده باشد. | اگر 6.1 Sol را دارید، همان کار را روی هر دو امتحان و نتیجه و مصرف را مقایسه کنید. |
| GPT-6 Luna | خلاصهسازی، استخراج داده، اصلاح محدود کد، دستهبندی و اتوماسیون پرتکرار. | برای مسئلهٔ مبهم یا تصمیمی با شواهد متناقض، Sol یا Astra را بسنجید. |
| GPT-5.6 Sol | پروژهای که از قبل با این مدل خوب کار میکند و فعلاً نمیخواهید روندش را وسط کار عوض کنید. | برای کار تازه، مدلهای نسل ۶ را روی نمونهٔ واقعی امتحان کنید. |
| GPT-5.6 Terra | کار روزمرهٔ میانه و اصلاحاتی که از Luna دشوارترند. | اگر 6 Sol با دسترسی و مصرف مناسب دارید، مقایسهٔ عملی انجام دهید. |
| GPT-5.6 Luna | وظیفهٔ کوچک، واضح و پرتکرار در روندهای قدیمیتر. | GPT-6 Luna در صورت دسترسی، گزینهٔ تازهتری برای مقایسه است. |
اینها پیشنهاد انتخاب کار هستند، نه رتبهبندی قطعی کیفیت برای همهٔ مسئلهها. راهنمای انتخاب مدل OpenAI هم توصیه میکند یک کار آشنا را با چند ترکیب مدل و میزان تفکر اجرا و کیفیت، زمان و مصرف را مقایسه کنید. اگر برای تدوین و سپردن یک پروژهٔ طولانی به مدل قویتر مثال عملی میخواهید، راهنمای Astra برای کار و ادیت ادامهٔ مرتبطی است.
High، Medium و Extra High چه چیزی را عوض میکنند؟
این گزینهها reasoning effort یا میزان تلاشی هستند که مدل برای فکرکردن به مسئله صرف میکند؛ مدل را عوض نمیکنند. در مستندات رسمی، Light/Low برای کار کوتاه و مشخص، Medium برای تعادل سرعت و عمق، و High و Extra High برای کار چندمرحلهای با منابع و بدهبستانهای بیشتر پیشنهاد شدهاند. نمایش و دامنهٔ گزینهها به مدل و محیط بستگی دارد.
| سطح | کاربرد نمونه | اثر معمول بر روند و مصرف |
|---|---|---|
| Light / Low | تغییر یک عنوان، استخراج چند داده، رفع یک خطای روشن | معمولاً پاسخ سریعتر و توکن تفکر کمتر؛ برای مسئلهٔ مبهم ممکن است بررسی کافی نباشد. |
| Medium | نوشتن پیشنویس مقاله، ساخت صفحه با نیازمندی مشخص، تحلیل چند فایل | نقطهٔ شروع خوب؛ زمان و مصرف میانه. |
| High | بازبینی کد پیچیده، بررسی چند منبع، برنامهٔ اجرایی با محدودیتها | ممکن است بررسی و برنامهریزی بیشتری انجام دهد؛ معمولاً زمان و توکن بیشتری میگیرد. |
| Extra High | تصمیم دشوار با شواهد متناقض یا خروجی حساس با چندین معیار | فرصت بیشتری برای تحلیل میدهد؛ افزایش کیفیت تضمینی و مصرف آن عدد ثابتی نیست. |
مثال: برای «رنگ دکمهٔ این صفحه را عوض کن» Luna با Low کافی است. برای «سه دلیل افت سرعت سایت را پیدا کن، با شواهد اولویتبندی کن و اصلاحات را تست کن» از Sol با Medium یا High شروع کنید. اگر مسئله هنوز مبهم و پرریسک بود، Extra High یا Astra را روی همان ورودی امتحان کنید. بالابردن سطح تفکر بهتنهایی جای دادهٔ درست، دسترسی مناسب و دستور روشن را نمیگیرد.
توکنهای تفکر بخشی از پردازش مدلاند و میتوانند در مصرف خروجی حساب شوند؛ در نتیجه High یا Extra High ممکن است توکن و کردیت بیشتری مصرف کند. این افزایش خطی یا تضمینشده نیست: مدل با توجه به سختی همان کار سازگارانه فکر میکند. راهنمای reasoning در API هم جهت کلی را روشن میکند: سطح پایینتر به سرعت و مصرف کمتر تمایل دارد، سطح بالاتر به بررسی عمیقتر.
Max و Ultra را با Extra High یکی نگیرید. Max زمان فکرکردن همان مدل روی یک مسئله را بیشتر میکند؛ Ultra میتواند بخشهای یک کار بزرگ را میان عاملهای جدا تقسیم کند و شرایط دسترسی خودش را دارد. برای بیشتر کارهای روزانه لازم نیست سراغ این دو بروید. Luna تا Max را پشتیبانی میکند، نه Ultra. توضیح رسمی تنظیمات جزئیات را دارد.
Speed 1.5 دقیقاً چه میکند؟
در انتخابگر، سرعت از میزان تفکر جداست. مستندات Speed OpenAI میگوید Fast mode برای مدلهای پشتیبانیشده خروجی را سریعتر تولید میکند؛ برای GPT-5.6 و GPT-5.5 افزایش سرعت اعلامشده ۱٫۵ برابر است. این عدد را نباید به همهٔ مدلهای GPT-6 تعمیم داد، یا به معنی تمامشدن کل پروژه در دو سوم زمان دانست: زمان ابزارها، جستوجو، شبکه و تأیید کاربر هم در مدت کل اثر دارد.
Fast مدل باهوشتری انتخاب نمیکند و مقدار reasoning effort را خودکار High نمیگذارد. بهای سرعت در Codex با ورود از حساب ChatGPT چنین است:
- از سهمیهٔ همراه اشتراک: مصرف Fast برای مدلهای پشتیبانیشده ۲٫۵ برابر Standard محاسبه میشود.
- از کردیت خریداریشده یا مصرف بر اساس پرداخت سازمانی: نرخ Fast ۲ برابر Standard است.
این دو ضریب، ضریب هزینه/مصرفاند، نه ضریب سرعت. برای GPT-6.1 Sol، Astra، Sol و Luna امکان Fast به پلن، محیط و عرضهٔ تدریجی بستگی دارد. Ultrafast جداست و در زمان نگارش فقط برای Astra در Pro 500 دلاری و برخی حسابهای Enterprise/Edu فعال است؛ قواعد مصرفش نیز جداست. با API key، نرخهای API اعمال میشود، نه ضریب کردیت اشتراک ChatGPT.
توکن، کردیت و سهمیهٔ پلن را جدا حساب کنید
توکن واحد متن ورودی، زمینهٔ گفتوگو، فایلها، نتیجهٔ ابزار و پاسخ است. کردیت واحد محاسبهٔ مصرف در پلنهای مبتنی بر کردیت یا پس از تمامشدن سهمیهٔ همراه اشتراک است. سهمیهٔ پلن هم محدودیت استفادهٔ شامل اشتراک است و لزوماً با تعداد پیام ثابت سنجیده نمیشود. Codex و ChatGPT Work مصرف مشترک دارند. راهنمای قیمتگذاری رسمی میگوید اندازهٔ پروژه، طول زمینه، ابزارها، مدل، تفکر و کش همگی روی مصرف اثر دارند؛ قیمت API را نباید برای تخمین تعداد کارهای داخل اشتراک به کار برد.
برای مقایسه، جدول زیر کردیت به ازای هر یکمیلیون توکن در حالت Standard است؛ ستون کش فقط برای ورودیِ کششده است. این جدول صورتحساب هر پیام را پیشبینی نمیکند:
| مدل | ورودی | ورودی کششده | خروجی |
|---|---|---|---|
| GPT-6 Astra | ۲۵۰ | ۲۵ | ۱۲۵۰ |
| GPT-6.1 Sol | ۵۰ | ۲٫۵ | ۲۵۰ |
| GPT-6 Sol | ۵۰ | ۵ | ۲۵۰ |
| GPT-6 Luna | ۲٫۵ | ۰٫۲۵ | ۱۲٫۵ |
| GPT-5.6 Sol | ۱۰۰ | ۱۰ | ۵۰۰ |
| GPT-5.6 Terra | ۵۰ | ۵ | ۳۰۰ |
| GPT-5.6 Luna | ۵ | ۰٫۵ | ۳۰ |
مثلاً اگر یک کار با GPT-6.1 Sol دقیقاً ۱۰۰ هزار توکن ورودیِ بدون کش و ۲۰ هزار توکن خروجی مصرف کند، در نرخ Standard مبتنی بر کردیت: ۰٫۱ × ۵۰ + ۰٫۰۲ × ۲۵۰ = ۱۰ کردیت. اگر همان تعداد توکن با Fast از کردیت خریداریشده پرداخت شود، نرخ ۲۰ کردیت میشود؛ از سهمیهٔ همراه اشتراک، مصرف معادل ۲٫۵ برابر Standard است. در کار واقعی، Fast یا High ممکن است تعداد توکنها را هم تغییر دهد، پس نتیجهٔ نهایی الزاماً همین اعداد نیست. نرخهای جاری را از جدول رسمی کردیت بررسی کنید.
حساب رایگان و پولی به کدام مدلها دسترسی دارد؟
تا ۵ اکتبر ۲۰۲۶، جمعبندی اعلامهای رسمی چنین است. این جدول دربارهٔ Codex/Work با ورود از حساب ChatGPT است؛ عرضهٔ تدریجی، نسخهٔ اپ، محیط و تنظیمات مدیر سازمان میتوانند فهرست واقعی شما را تغییر دهند.
| پلن | دسترسی اعلامشدهٔ مهم برای این فهرست |
|---|---|
| Free و Go | GPT-6 Luna با سرعت Standard در اپ دسکتاپ، بهشرط فعالشدن عرضه. GPT-6.1 Sol در عرضهٔ اولیه برای این دو پلن نیست. برای بقیهٔ گزینههای تصویر، دسترسی عمومی و یکسانی تأیید نشده است. |
| Plus | GPT-6.1 Sol، GPT-6 Sol و GPT-6 Luna در سطوح پشتیبانیشده؛ Astra و خانوادهٔ GPT-5.6 نیز بسته به عرضه و انتخابگر حساب. سهمیهٔ مصرف دارد. |
| Pro | گزینههای Plus با ظرفیت بیشتر؛ سطح ۵۰۰ دلاری میتواند Astra Ultrafast را هم داشته باشد. وجود Astra Extra High در همهٔ پلنهای پولی تضمین نشده است. |
| Business | مدلهای جدید در عرضهٔ مربوط؛ دسترسی دقیق و سهمیه به فضای کاری بستگی دارد. |
| Enterprise و Edu | مدلهای جدید با فعالسازی مدیر؛ GPT-6.1 Sol بهطور پیشفرض خاموش است. Ultrafast فقط برای حسابهای واجد شرایط و با تنظیمات لازم. |
| API key | فهرست و هزینه تابع دسترسی API همان کلید است؛ این جدول پلنهای ChatGPT و ضریب کردیت آن به API تعمیم ندارد. |
برای Plus و Business Standard، برآورد رسمی تعداد پیام محلی در هر پنج ساعت حدود ۵ تا ۴۵ برای Astra، ۱۵ تا ۱۶۰ برای GPT-6.1 Sol، ۱۵ تا ۱۵۰ برای GPT-6 Sol و ۳۵۰ تا ۳۰۰۰ برای GPT-6 Luna است؛ اینها سقف ثابت پیام نیستند. محدودیت هفتگی هم ممکن است اعمال شود. برای دسترسی واقعی و ماندهٔ حساب، خود انتخابگر و داشبورد مصرف را ببینید.
جمعبندی انتخاب سریع
برای کار مشخص و زیاد، Luna را با Low یا Medium امتحان کنید. برای پروژهٔ چندمرحلهای، از GPT-6.1 Sol یا GPT-6 Sol با Medium شروع کنید و فقط اگر خروجی به بررسی بیشتری نیاز داشت به High بروید. برای کار سخت با منابع و تصمیمهای حساس، Astra و در صورت نیاز Extra High را روی یک نمونهٔ واقعی بسنجید. Fast را وقتی ارزش زمان پاسخ از مصرف بیشتر سهمیه یا کردیت بالاتر است روشن کنید.
و اگر هنوز از GPT-5.5 در Codex یا Work استفاده میکنید: تا چهارشنبه ۲۲ مهر ۱۴۰۵ / ۱۴ اکتبر ۲۰۲۶ مدل جایگزینِ در دسترس پلن خود را انتخاب و تنظیمات ذخیرهشده را بهروز کنید؛ این موعد برای API نیست.